快速回答:如果你想构建一个人们真正会使用的CBT日记用户体验,你必须砍掉标准的心情表情符号。在Vividiary,我们意识到基本的心情追踪只能告诉用户他们的感受,而不能告诉他们原因。我们最初测试了一种传统的7步临床CBT表格,但在用户测试中看到高达60%的流失率后,我们拒绝了它——它感觉太像家庭作业了。相反,我们转向了对话式触发因素映射。为了实现这一点,我们需要强大的LLM推理能力。我们明确拒绝了端侧AI,因为本地模型无法进行细致的认知重构。我们选择了隐私优先的云架构,确保你的零方数据在被重度加密的同时,仍能提供用户理解其心理健康所需的深度、情境化见解。
---
当我们第一次坐下来设计Vividiary时,我们做了其他所有心理健康应用都会做的事:我们设计了一个由精美插图组成的心情表情符号大网格。
我们花了数周时间争论“忧郁”与“悲伤”之间蓝色的确切色调。我们以为自己在构建终极的情绪词汇工具。但当我们把它放在真实用户面前时,数据像重锤一样击中了我们。人们花费15到20秒的时间盯着屏幕,因选择困难而瘫痪,最后强制关闭了应用。
我们意识到关于我们产品的一个残酷事实:传统的心情追踪从根本上是有缺陷的。它只测量结果(情绪),而没有揭示原因(触发因素)。它留给用户的是一张关于他们痛苦的彩色图表,但完全没有可操作的后续步骤来解决它。
以下是我们如何拆除原始设计、我们尝试了什么替代方案,以及为什么我们彻底重构Vividiary以专注于触发因素映射的内幕故事。
为什么我们砍掉了标准的心情表情符号
问题所在 最初的目标很简单:给用户一种记录他们感受的方式。行业标准规定,你应该向用户展示20-30个代表情绪谱系的表情符号。
但在我们早期的Beta测试中,我们注意到一个明显的问题。当用户处于高度情绪困扰状态时——比如他们刚刚经历了恐慌发作或与伴侣发生了剧烈争吵——他们最不想做的事情就是玩“沃尔多在哪里?”,在表情符号网格中寻找那个能完美概括“焦虑但又愤怒且有点饿”的表情。
此外,孤立地记录一种情绪并不能帮助情绪调节。如果你的数据显示你周二“愤怒”、周三“悲伤”、周四“焦虑”,你该如何利用这些信息?什么也做不了。这是一个死胡同。
我们选择的方法 我们决定砍掉作为主要输入的表情符号网格。我们用一个彻底精简的5级心情系统取而代之:最好、好、中性、低、最差。
我们将特定的表情符号降级为一个可选的多选屏幕,用于记录具体的情绪和活动,仅在初始记录的摩擦力消除后才可见。
为什么?因为点击五个大按钮中的一个只需3秒。它极大地降低了认知负荷。在我们后续的A/B测试中,这一简单的改变使每日记录完成率提高了41%。如果你对这背后的深层心理学感到好奇,我曾广泛撰写过关于我们情绪驱动的产品设计的文章,以及为什么不干扰用户是设计师能做的最好的事情。
我们拒绝的方案:7步临床CBT表格
问题所在 一旦我们简化了心情输入,我们就需要一种方法来捕捉“背景”——即心情背后的“原因”。认知行为疗法(CBT)是这方面的黄金标准。所以,自然地,我们认为我们应该直接数字化一份CBT工作表。
我们考虑过(并砍掉)的方法 我们构建了一个全面的、7步临床CBT表格。它要求用户手动填写文本框以记录: 1. 情境 2. 最初的想法 3. 情绪(及强度1-100) 4. 身体感觉 5. 行为/行动 6. 存在的认知扭曲 7. 替代/重构的想法
从临床角度来看,这很完美。这正是治疗师会给你的一张纸。
从产品角度来看,这是一场彻底的灾难。
我们学到了什么 我们将此方案推向了一组500名Beta测试者。结果是残酷的。我们看到第三天的60%流失率。
当我们进行用户访谈时,反馈是一致的:“这感觉像是在做家庭作业。”
用户告诉我们,当他们感到“低”或“最差”时,写下七段深度心理分析的前景让他们感到不知所措。我们要求用户在他们情绪失调时进行认知重构的繁重工作。这是在错误的时间使用了错误的工具。虽然这些临床CBT日记技巧在治疗师的办公室里非常有效,但作为一种自助式移动端用户体验,它们彻底失败了。
触发因素映射:构建真正有效的CBT日记用户体验
解决方案 如果静态表格感觉像家庭作业,那么什么感觉自然?对话。
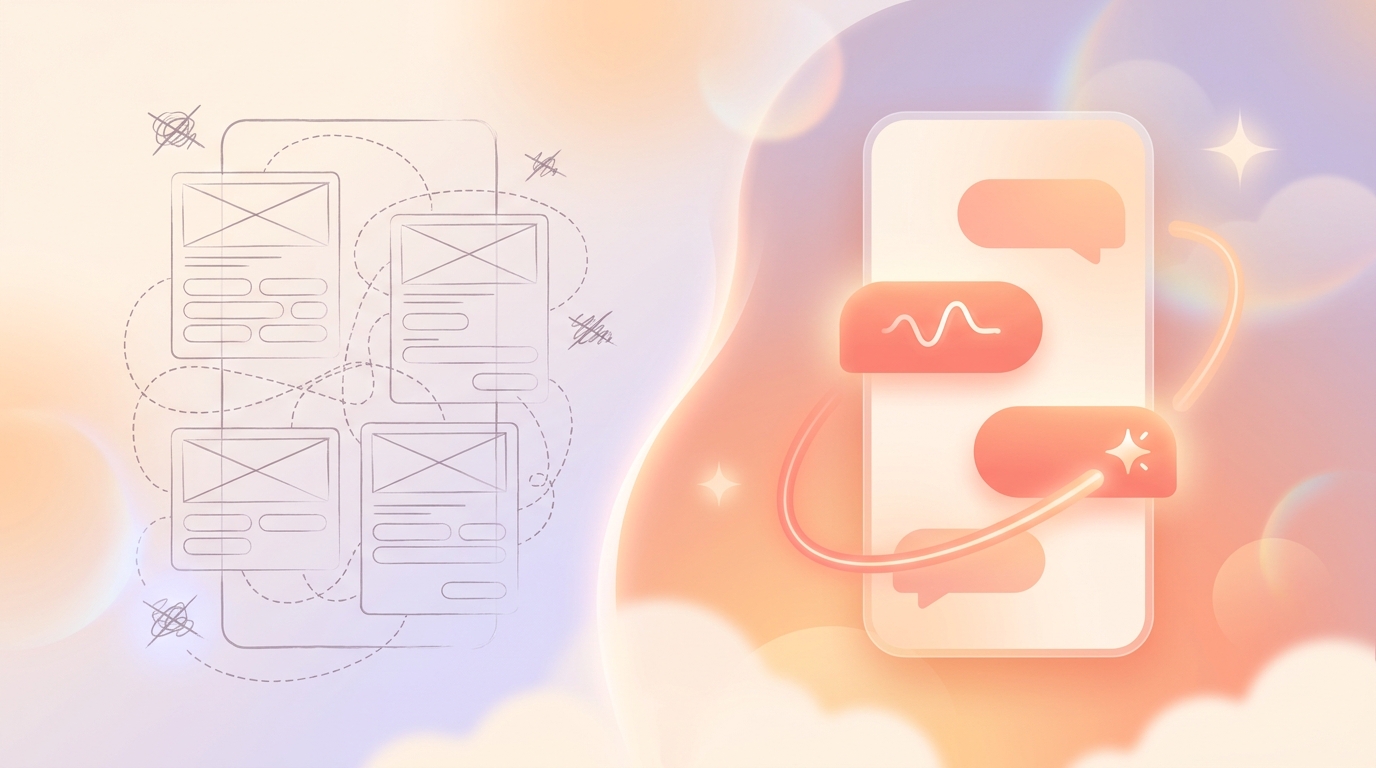
我们彻底废弃了7步表格,转向了AI驱动的对话式UI。我们引入了一种AI对话模式——支持语音和文本——它充当了一个温柔、好奇的倾听者。
AI不再预先要求七个数据点,而是简单地问:“今天有什么心事吗?”当用户倾诉时,AI会提出有针对性的、符合CBT原则的后续问题。
用户:“我非常担心明天的演讲。我知道我会搞砸的。”
AI:“听起来那场演讲让你压力很大。具体是什么让你觉得你会搞砸它呢?”
在后台,AI正在进行繁重的工作。它在默默地提取情境、情绪和认知扭曲(在这种情况下是“算命”)。当对话自然结束时,AI会无缝生成一份第一人称日记草稿,供用户查看、编辑和保存。
为什么这是游戏规则的改变者:触发因素映射 这种无摩擦的收集方法弥合了简单记录感受与理解其根本原因之间的鸿沟。通过以对话方式捕捉背景,我们可以执行触发因素映射。
触发因素映射允许我们的系统随着时间的推移连接点。我们可以向用户展示:“嘿,我们注意到你80%次记录‘低’心情时,之前都有关于你经理的对话。”
为了使这些数据易于消化,我们构建了高级分析功能。虽然我们的免费层级提供无限的心情记录、每天3次AI对话和基础分析,但我们将重度数据可视化保留给了我们的高级层级(每月$2.99或每年$11.99)。高级用户可以访问每周和每月的心情报告、气泡图和热图,这些图表可视化了这些行为循环。
游戏化用户体验 但CBT仍然是一项艰苦的工作。为了在困难的反思过程中保持参与度,我们引入了游戏化用户体验。当用户记录心情并完成触发因素映射会话时,他们会培养一个“粘土(Clay)”角色。在30天内,这个角色会成长并演变成8种最终形态之一,直接受用户情绪数据的影响。它将常规的、有时是痛苦的记录过程转化为一段有益的自我发现之旅。
架构:为什么我们选择隐私优先的云架构而非端侧AI
问题所在 触发因素映射要求用户分享极其私人的背景信息。如果用户要向我们的应用讲述他们的婚姻问题、职场焦虑或内心深处的不安全感,他们需要一个铁定的保证,即他们的数据是安全的。
Vividiary从根本上是一个零方数据健康应用。零方数据是客户有意且主动与品牌共享的数据。它非常可靠,但需要极大的信任。
我们考虑过的方法 在设计AI架构时,我们内部就AI处理应该在哪里进行进行了激烈的辩论。
方法1:端侧AI
我们强烈考虑过直接在用户手机上运行小型、本地化的LLM。吸引力显而易见:如果数据从未离开设备进行处理,隐私在理论上更容易营销。
方法2:基于云的LLM
使用托管在云端的尖端模型(如OpenAI的GPT-4或Anthropic的Claude),需要将数据发送到网络进行处理。
我们选择了什么(以及为什么) 我们明确拒绝了端侧AI。
为什么?因为本地移动模型目前还不够聪明。当我们测试7B参数的本地模型进行CBT重构时,结果要么非常通用(“别担心,要快乐!”),要么完全是幻觉。细致的认知重构需要强大的推理能力。如果AI给出糟糕的心理反馈,这不仅是糟糕的用户体验,还可能对用户的心理健康造成潜在伤害。
相反,我们选择了隐私优先的云架构。我们使用基于云的LLM来确保最高质量的CBT推理。
我们是如何构建它的 为了保护这些敏感的零方数据,我们基于现代、高度安全的堆栈构建了Vividiary:前端使用React Native (Expo),后端数据库使用Supabase,订阅管理使用RevenueCat,安全用户认证使用Firebase Auth。
由于数据必须传输到云端才能由AI处理,我们采用了严格的隐私优先设计原则。所有数据在传输中(通过TLS)和在我们的Supabase数据库中存储时都经过了重度加密。我们将你的日记条目视为医疗记录。我们不出售你的数据,我们不用你的个人日记来训练我们自己的基础模型,并确保我们的云基础设施符合严格的安全标准。
我们选择了透明度而非营销噱头。我们不会声称你的数据是“在本地处理的”,因为它不是。它是在高度安全的云环境中处理的,这样你就能在不损害隐私的情况下获得尽可能好的CBT见解。
数据:关于我们30天留存率的残酷事实
那么,这一切奏效了吗?
我承诺过要坦诚,所以让我们看看数字。当我们运行7步临床表格时,我们的第30天留存率是惨淡的12%。人们会下载应用,意识到工作量太大,然后流失。
在我们砍掉心情表情符号网格、引入3秒5级心情记录器、推出对话式触发因素映射并添加了进化的粘土角色后,我们的第30天留存率跃升至34%。
如果你想深入了解具体的群体以及我们如何衡量成功,你可以阅读我们关于30天留存指标的完整分析。
我们学到了什么 健康与保健类别中34%的第30天留存率非常强劲,但并不完美。
我们了解到,一些用户仍然觉得AI对话有点怪异。大约15%的用户完全选择不使用AI聊天,宁愿只使用5级心情记录器并写下他们自己的手动笔记。我们还了解到,我们的语音转文字功能虽然受欢迎,但在处理重口音时表现不佳,这是我们的工程团队正在积极改进的地方。
接下来是什么 我们目前正在为高级层级构建更强大的触发因素映射可视化,允许用户将他们的心情数据与外部因素(如天气、睡眠数据(通过Apple Health集成)和屏幕时间)进行交叉参考。
构建CBT日记用户体验是在临床疗效与人类摩擦力之间取得平衡的练习。如果你做得太临床,用户会放弃。如果你做得太简单(像表情符号网格),用户将无法获得任何价值。通过专注于对话式触发因素映射和隐私优先的云架构,我们相信我们终于找到了最佳平衡点。