当我们刚开始构建 Vividiary 时,我们有一个非常简单,甚至有些天真的假设:与 AI 谈论你的一天比盯着空白页面更容易。
关于这一点我们是对的。我们早期的内测显示,用户非常喜欢这种对话式界面。但在第 14 天,发生了一件令人担忧的事情。我们的留存曲线断崖式下跌。72% 的内测用户在第二周流失了。
我联系了十几位流失的用户,并邀请他们喝了虚拟咖啡。反馈是一致且残酷的:“感觉就像在和一个患有严重短期记忆丧失症的人交谈。我每天都得重新解释我的老板是谁,为什么我对即将到来的搬家感到压力,以及我平时的焦虑感是什么样的。”
他们完全正确。我们造出了一个失忆症患者。
如果你想弄清楚如何构建一个真正能留住用户数月甚至数年的 AI 日记应用,你必须解决记忆问题。用户期望 AI 日记伴侣能够记住他们的情感历史,识别模式,并与他们共同成长。
但构建用于日记的 LLM 记忆架构并不像保存聊天记录那么简单。它需要处理性能、成本和严格数据隐私之间的复杂三难困境。以下是我们如何构建 Vividiary 记忆的坦诚回顾,包括我们抛弃的方法,以及我们至今仍在应对的工程权衡。
失忆 AI 日记的问题
传统的 LLM 在设计上是无状态的。每次你开启一个新会话,模型就像新生儿一样,完全不知道你昨天进行的对话。
对于编程助手来说,这没问题。但对于健康和日记应用来说,这是一个致命的缺陷。写日记本质上是累积性的。其价值不仅仅来自记录某一天,而是来自连接数周和数月以来的点点滴滴。
在我们处理 AI 记忆之前,我们必须先修复数据输入。我们意识到,强迫用户直接进入开放式聊天会产生阻力。因此,我们设计了核心循环,从一个快速的、3 秒的 5 级心情签到(从最好到最差)开始,并辅以可选的情绪和活动标签。
这种结构化、低门槛的入口点在对话开始前就为 AI 提供了关于用户当前状态的即时、硬性数据。但一旦对话开始,AI 如何知道为什么今天“最差”的心情可能与三周前某个周二的“糟糕”心情有关呢?
我们拒绝的方法:天真的上下文窗口方案
当我们意识到需要长期记忆时,我们的工程团队坐下来规划了最简单的解决方案。我们称之为“上下文窗口填充器”。
拒绝的方法 1:填充提示词 想法很简单:每次用户开始新聊天时,只需抓取他们最近的 30 条日记,将它们隐形地粘贴到系统提示词中,然后说:“这是用户的历史记录。现在和他们交谈。”
- 延迟: 我们进行了一项测试,将 15,000 个 token 的过去日记条目注入提示词中。首字生成时间 (TTFT) 飙升至 8.4 秒。在移动应用用户体验中,8.4 秒简直是永恒。65% 的测试用户在 AI 回复之前就放弃了生成。
- 成本: 在每次交互中向 LLM 发送海量的冗余文本对于初创公司来说是财务自杀。我们很快意识到,如果我们的 token 使用量随用户使用时长线性增长,那么平衡云端 AI 成本是不可能的。
- “迷失在中间”现象: LLM 以无法回忆起埋在海量提示词中间的信息而闻名。AI 会记得第一条和最后一条,但完全忽略两周前的情感背景。
拒绝的方法 2:滚动摘要链 接下来,我们尝试了滚动摘要。每天结束时,AI 会阅读新条目,阅读之前的摘要,并写出一份用户生活的新主摘要。
我们放弃它的原因:
它破坏了细微差别。摘要会说:“Ethan 对工作感到压力。”但它丢失了具体的、颗粒度高的细节——比如我实际上是因为与特定供应商在 10 点进行的定期同步会议而感到压力。当 AI 后来试图提起我的压力时,听起来很笼统且机械。它缺乏那种来自具体回忆的同理心。
设计我们的隐私优先云架构
我们意识到我们需要一个系统,能够在需要时精确地选择性检索相关的过去记忆,而不会导致 token 数量激增或损害高度敏感个人数据的安全性。
此外,我们必须在隐私方面毫不妥协。Vividiary 是一个隐私优先的平台。虽然我们将数据存储在云端以实现无缝的跨设备同步和高级 AI 处理,但我们以最高级别的加密尊重对待这些数据。所有数据在传输和存储时均已加密。
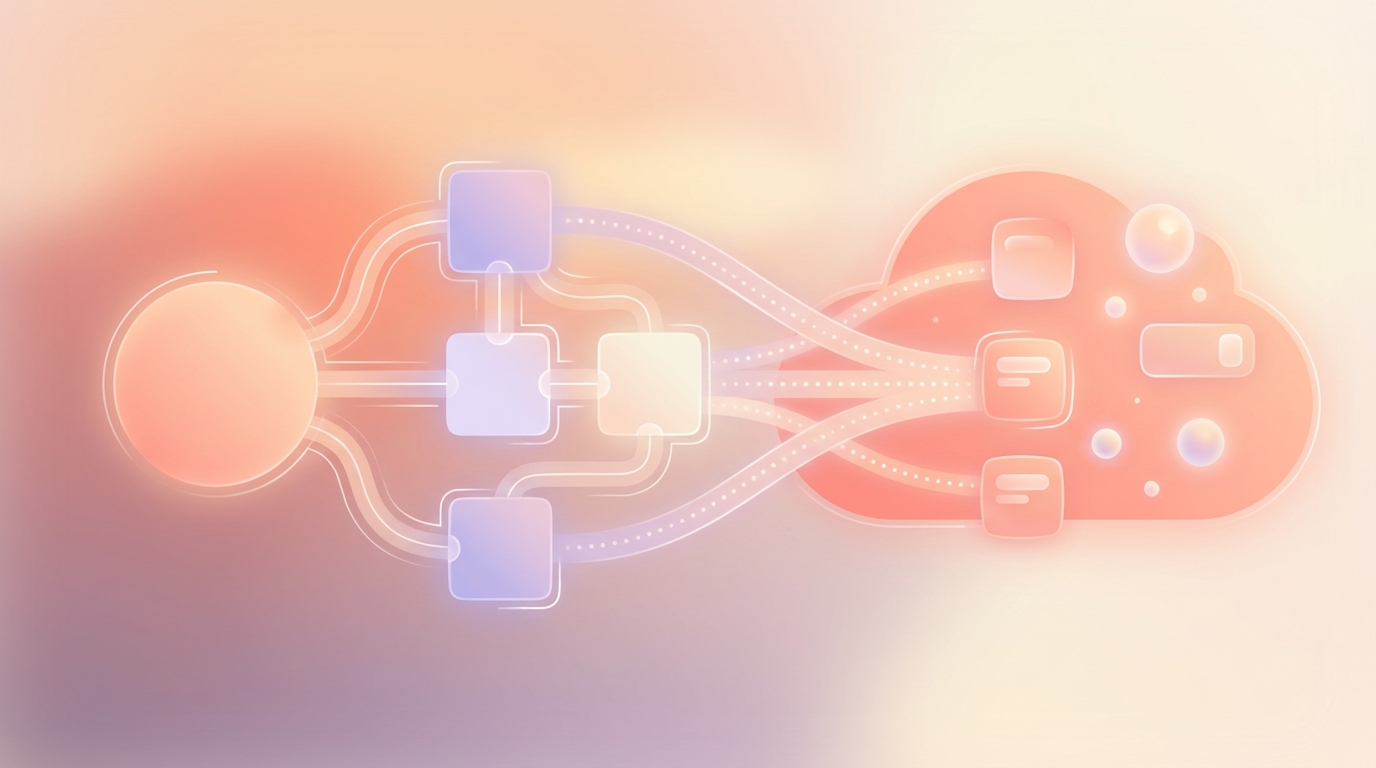
这就是我们选择构建的方案:一种基于向量的检索增强生成 (RAG) 架构,专门针对情感背景进行了调整。
第 1 步:优化记忆形成 我们很早就做出了一个关键的产品决策:我们不存储杂乱无章的聊天记录。
当你与 Vividiary AI 交谈时,对话只是一个工具。它充当对话结构代理。当你聊完后,AI 会综合对话并生成一份第一人称的日记草稿。“今天,我感到不知所措,因为……”
用户查看、编辑并批准这份草稿。这确保了用户始终是自己故事的作者。对于我们的架构来说,更重要的是,这意味着我们存储的“记忆”是一个干净、结构化、经用户批准的叙述,而不是 40 行杂乱的聊天机器人对话。
第 2 步:向量嵌入 一旦用户批准了条目,我们就将该文本通过嵌入模型。将嵌入模型想象成一台机器,它读取文本并将其分配到海量多维地图上的一组坐标。
关于“工作压力”的条目聚集在地图的一个区域。关于“家庭快乐”的条目聚集在另一个区域。我们将这些数学坐标(向量)安全地存储在我们的云数据库 (Supabase) 中。
第 3 步:上下文检索 现在,假设用户在周二记录了一个“最差”的心情并标记了“焦虑”。
在 AI 打招呼之前,我们的系统就会获取该当前状态,将其转换为向量,并在用户的加密云数据库中搜索数学上最接近的过去条目。它找到了过去两个月内用户感到类似焦虑的三条记录。
我们将仅那三条高度相关的条目注入到 AI 的提示词中。
结果如何?AI 会立即回复(低延迟),成本仅为几分之一美分(低 token 使用量),并说:“我看到你今天感到焦虑。我记得上个月你在季度评估前也有过类似的感觉。今天的焦虑与工作有关,还是其他原因?”
这就是神奇的时刻。这就是 AI 不再是聊天机器人,而成为伴侣的时刻。
向量搜索如何呈现长期情感模式
这种架构不仅使日常聊天变得更好,还驱动了应用的整个分析后端。
因为我们已经在数学上映射了用户的情感状态,所以我们可以将其可视化。这就是我们的免费增值模式发挥作用的地方。每个用户每天免费获得无限的心情记录和 3 次 AI 对话。但对于想要深入挖掘的用户,我们的高级会员($2.99/月或 $11.99/年)可以解锁高级视觉洞察。
利用向量数据,我们生成气泡图和热力图,向用户准确展示哪些活动和主题与他们最好和最差的日子相关联。这种AI 情感模式识别对于应对倦怠或慢性压力的用户来说是颠覆性的。他们不必猜测是什么在消耗他们;数据会告诉他们。
我们还将这种记忆直接与我们的游戏化循环联系起来。Vividiary 具有一个 30 天进化的“粘土”角色。当你记录心情且 AI 学习你的模式时,粘土角色会发生视觉进化,为你提供心理健康之旅的有形、游戏化表现。粘土的视觉状态直接受到从我们向量数据库中提取的情感分析的影响。
我们仍在应对的工程权衡
我承诺过要坦诚,所以我不会假装这个系统是完美的。构建现代健康应用技术栈 2026 涉及不断的妥协。我们当前的技术栈——前端使用 React Native 和 Expo,PostgreSQL/向量数据库使用 Supabase,身份管理使用 Firebase Auth,订阅使用 RevenueCat——非常强大,但也面临挑战。
权衡 1:语义搜索与时间现实 向量搜索在寻找主题相似的条目方面非常出色,但它没有内在的时间感。
在早期测试中,如果用户说“我为我的狗感到难过”,AI 可能会检索到四年前上一只狗去世时的条目,而不是昨天现在的狗去看兽医的条目。
为了解决这个问题,我们不得不构建一个混合搜索系统。我们现在使用一种衰减算法,将最近的条目权重设置得略高于旧条目,同时仍然允许高度相关的旧条目被检索出来。调整这些权重是我们工程团队每周都在进行的战斗。
权衡 2:同理心与临床观察的界限 当 AI 拥有完美的记忆时,有时会显得令人毛骨悚然或过于临床。在我们向量检索的第一次迭代中,AI 会自豪地列出过去的创伤以证明它记得。这让人感到不安。
我们不得不彻底重构系统提示词,专注于情感 AI 用户体验设计。我们训练模型将过去的记忆作为语气的背景,而不是作为要背诵的琐事事实。我们意识到,好的情感驱动产品设计意味着 AI 应该感觉像一个支持你的朋友,记得你的历史,而不是一个阅读档案的侦探。
接下来是什么
我们目前正在尝试将“实体提取”与我们的向量嵌入结合使用。这意味着系统将专门学习并安全地存储你生活中重要的人、地点和宠物的名单,确保它永远不会忘记你的伴侣或最好的朋友的名字。
构建一个有记忆的 AI 很困难。构建一个尊重隐私、以闪电般速度运行并真正帮助人们了解自己思想的 AI 更难。但当我们看到那些体验过第一次“回调”时刻的用户留存指标时——当 AI 记住了一些非常私人的事情并用它来提供安慰时——我们知道这些架构上的头痛是完全值得的。