當我們剛開始開發 Vividiary 時,我們有一個非常簡單、甚至有點天真的假設:與 AI 談論你的一天比盯著空白頁面更容易。
關於這一點我們是對的。我們早期的 Beta 測試顯示,使用者非常喜歡這種對話式介面。但在第 14 天,發生了一件令人擔憂的事。我們的留存率曲線呈現斷崖式下跌。我們 72% 的 Beta 測試使用者在第二週就流失了。
我聯繫了十幾位流失的使用者,並與他們進行了虛擬咖啡對談。回饋意見一致且殘酷:「感覺就像在跟一個有嚴重短期記憶喪失的人說話。我每天都得重新解釋我的老闆是誰、為什麼我對即將到來的搬家感到壓力,以及我平時的焦慮感是什麼樣子的。」
他們完全正確。我們打造出了一個失憶症患者。
如果你想弄清楚如何打造一款能真正留住使用者數月甚至數年的 AI 日記應用程式,你必須解決記憶問題。使用者期望 AI 日記夥伴能記住他們的情緒歷史、識別模式,並與他們共同成長。
但建立 LLM 日記記憶架構並不像儲存聊天記錄那麼簡單。它需要處理效能、成本和嚴格資料隱私之間複雜的三難困境。以下是我們如何建立 Vividiary 記憶的坦誠分享,包括我們丟棄的方法,以及我們至今仍在處理的工程取捨。
失憶 AI 日記的問題
傳統 LLM 在設計上是無狀態的。每次你開啟一個新對話,模型就像剛誕生一樣,完全不知道你昨天聊了什麼。
對於程式設計助手來說,這沒問題。但對於健康和日記應用程式來說,這是一個致命的缺陷。寫日記本質上是累積性的。其價值不僅來自於記錄單一的一天;更來自於連結數週和數月以來的點點滴滴。
在我們處理 AI 記憶之前,必須先修復資料輸入方式。我們意識到強迫使用者直接進入開放式聊天會產生阻力。因此,我們設計了核心流程,從一個快速的、3 秒的 5 等級心情簽到(從最好到最差)開始,並輔以可選的情緒和活動標籤。
這個結構化、低門檻的切入點,讓 AI 在對話開始前就能獲得關於使用者當前狀態的即時、硬性資料。但一旦對話開始,AI 如何知道為什麼今天「最差」的心情可能與三週前的某個星期二「糟糕」的心情有關?
我們拒絕的方法:天真的上下文視窗做法
當我們意識到需要長期記憶時,我們的工程團隊坐下來規劃了最簡單的解決方案。我們稱之為「上下文視窗填充器」(Context Window Stuffer)。
拒絕的方法 1:填充提示詞 這個想法很簡單:每次使用者開始新對話時,只需抓取他們過去 30 篇日記,將其隱形地貼入系統提示詞中,並說:「這是使用者的歷史紀錄。現在跟他們對話。」
- 延遲: 我們進行了一項測試,將 15,000 個 token 的過去日記內容注入提示詞中。首字延遲(TTFT)飆升至 8.4 秒。在行動應用程式 UX 中,8.4 秒簡直是永恆。我們 65% 的測試使用者在 AI 回覆之前就放棄了生成。
- 成本: 在每次互動中向 LLM 發送海量的冗餘文字,對新創公司來說是財務自殺。我們很快意識到,如果我們的 token 使用量隨著使用者使用時間線性增加,平衡雲端 AI 成本是不可能的。
- 「迷失在中間」現象: LLM 以無法回憶起埋藏在龐大提示詞中間的資訊而聞名。AI 會記得第一篇和最後一篇日記,但完全忽略了兩週前的情緒背景。
拒絕的方法 2:滾動摘要鏈 接下來,我們嘗試了滾動摘要。每天結束時,AI 會閱讀新日記,閱讀之前的摘要,並撰寫一份關於使用者生活的新總結。
為什麼我們放棄了它:
它破壞了細微差別。摘要可能會說:「Ethan 對工作感到壓力。」 但它丟失了具體的、細節的資訊——例如我實際上是因為與特定供應商在 10 AM 的定期同步會議而感到壓力。當 AI 後來試圖提起我的壓力時,聽起來很籠統且機械化。它缺乏來自具體回憶所產生的同理心。
設計我們以隱私為優先的雲端架構
我們意識到需要一個系統,能夠在需要時精確地選擇性檢索「相關」的過去記憶,而不會導致 token 數量膨脹或損害高度敏感的個人資料安全性。
此外,我們必須在隱私方面毫不妥協。Vividiary 是一個以隱私為優先的平台。雖然我們將資料儲存在雲端以實現無縫的跨裝置同步和進階 AI 處理,但我們以最高等級的加密標準對待這些資料。所有資料在傳輸和靜態儲存時皆已加密。
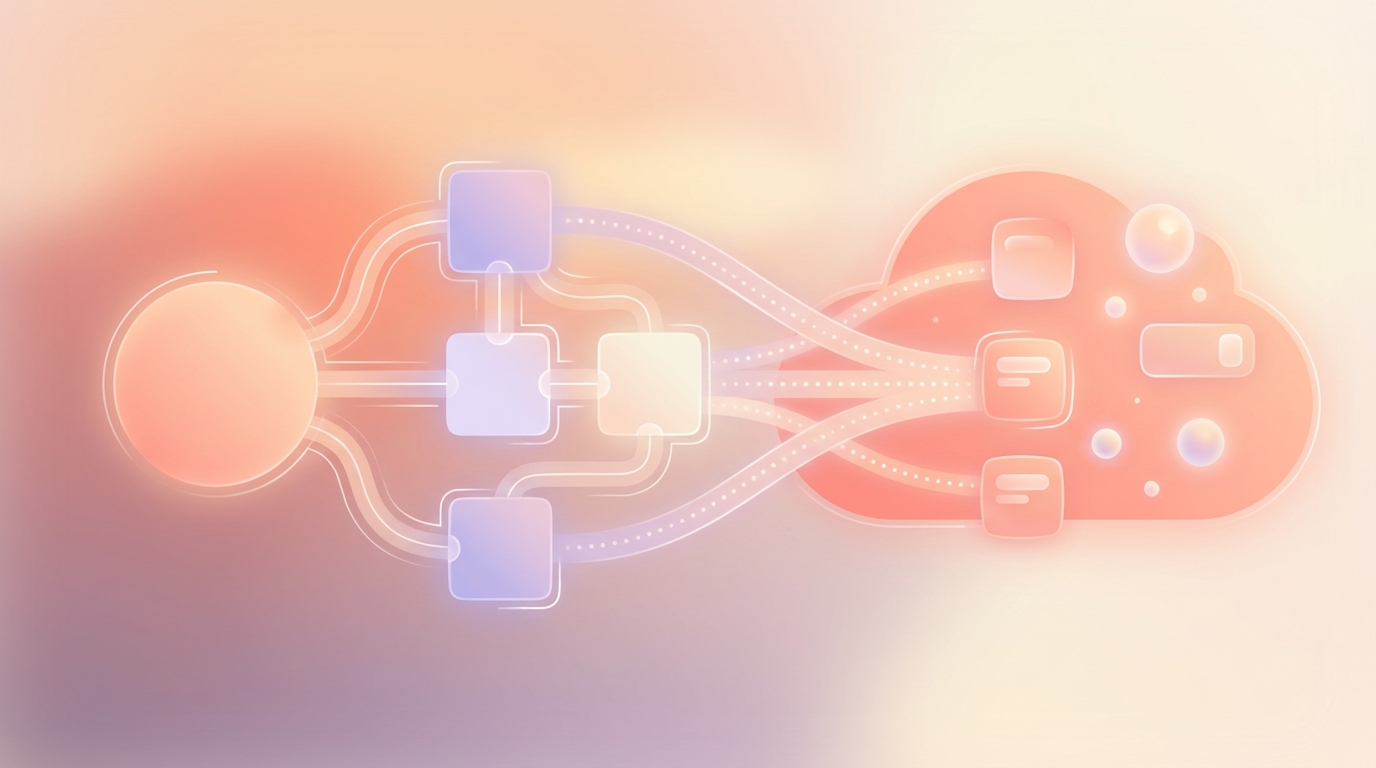
這就是我們選擇建立的架構:基於向量的檢索增強生成(RAG)架構,專門針對情緒背景進行了調整。
步驟 1:優化記憶形成 我們在早期做出了一個關鍵的產品決策:我們不儲存雜亂、非結構化的聊天記錄。
當你與 Vividiary AI 對話時,對話只是一種工具。它充當對話結構代理。當你聊完後,AI 會綜合對話並生成一份第一人稱的日記草稿。「今天,我感到不知所措,因為……」
使用者審閱、編輯並批准此草稿。這確保了使用者始終是自己故事的作者。對我們的架構而言更重要的是,這意味著我們儲存的「記憶」是一份乾淨、結構化、經使用者批准的敘述,而不是 40 行混亂的聊天機器人對話。
步驟 2:向量嵌入 一旦使用者批准了日記,我們就會將該文字通過嵌入模型。將嵌入模型想像成一台機器,它讀取文字並在龐大的多維地圖上為其分配一組座標。
關於「工作壓力」的日記會在地圖的同一區域聚集。關於「家庭快樂」的日記則聚集在另一處。我們將這些數學座標(向量)安全地儲存在我們的雲端資料庫(Supabase)中。
步驟 3:情境檢索 現在,假設使用者在週二記錄了「最差」的心情並標記了「焦慮」。
在 AI 打招呼之前,我們的系統會獲取當前狀態,將其轉換為向量,並在使用者加密的雲端資料庫中搜尋數學上最接近的過去日記。它會找到過去兩個月內使用者感到類似焦慮的三篇日記。
我們只將這三篇高度相關的日記注入 AI 的提示詞中。
結果如何?AI 回覆迅速(低延遲),成本僅佔幾分錢(低 token 使用量),並說:「我看到你今天感到焦慮。我記得上個月你在季度審查前也有類似的感覺。今天的焦慮與工作有關,還是其他原因?」
這就是魔法時刻。這就是 AI 不再只是聊天機器人,而成為夥伴的時刻。
向量搜尋如何呈現長期情緒模式
這種架構不僅讓日常聊天變得更好,還為應用程式的整個分析後端提供了動力。
因為我們已經以數學方式映射了使用者的情緒狀態,所以我們可以將其視覺化。這就是我們的免費增值模式發揮作用的地方。每位使用者每天都可以免費獲得無限的心情記錄和 3 次 AI 對話。但對於想要深入挖掘的使用者,我們的進階版(每月 $2.99 或每年 $11.99)解鎖了進階視覺化洞察。
利用向量資料,我們生成氣泡圖和熱圖,向使用者精確展示哪些活動和主題與他們最好和最差的日子相關聯。這種 AI 情緒模式識別對於處理倦怠或慢性壓力的使用者來說是一個遊戲規則改變者。他們不必猜測是什麼在消耗他們;資料會直接顯示出來。
我們也將此記憶直接連結到我們的遊戲化循環中。Vividiary 具有一個 30 天演進的「黏土」(Clay)角色。當你記錄心情且 AI 學習你的模式時,黏土角色會視覺化演進,提供你心理健康旅程的有形、遊戲化呈現。黏土的視覺狀態直接受到從我們向量資料庫中提取的情緒分析影響。
我們仍在處理的工程取捨
我承諾過要坦誠,所以我不會假裝這個系統完美無缺。建立現代 健康應用程式技術堆疊 2026 涉及不斷的妥協。我們目前的堆疊——前端使用 React Native 和 Expo,Supabase 用於 PostgreSQL/向量資料庫,Firebase Auth 用於安全身分管理,RevenueCat 用於訂閱——非常強大,但也面臨挑戰。
取捨 1:語意搜尋 vs. 時間現實 向量搜尋在尋找「主題」相似的日記方面非常出色,但它沒有內建的時間感。
在早期測試中,如果使用者說:「我為我的狗感到難過」,AI 可能會檢索到四年前上一隻狗過世時的日記,而不是昨天帶現任狗狗去看獸醫的日記。
為了修復這個問題,我們必須建立一個混合搜尋系統。我們現在使用一種衰減演算法,將近期日記的權重設定得比舊日記稍高,同時仍允許高度相關的舊日記被檢索出來。調整這些權重是我們工程團隊每週都在進行的戰鬥。
取捨 2:同理心 vs. 臨床觀察的界線 當 AI 擁有完美的記憶時,有時會顯得令人毛骨悚然或過於臨床。在我們向量檢索的第一個版本中,AI 會自豪地列出過去的創傷來證明它記得。這讓人感到不適。
我們必須徹底修改系統提示詞,以專注於 情緒 AI UX 設計。我們訓練模型將過去的記憶作為語氣的「背景」,而不是作為要背誦的瑣事。我們意識到良好的 情緒驅動產品設計意味著 AI 應該感覺像是一個記得你歷史的支持性朋友,而不是一個從檔案中朗讀的偵探。
接下來是什麼
我們目前正在嘗試將「實體提取」(Entity Extraction)與我們的向量嵌入結合使用。這意味著系統將專門學習並安全地儲存你生活中重要的人、地點和寵物的名單,確保它永遠不會忘記你的伴侶或最好的朋友的名字。
建立一個有記憶的 AI 很難。建立一個尊重隱私、運作速度極快,並真正幫助人們理解自己心靈的 AI 更難。但當我們看到那些體驗過第一次「回憶」時刻的使用者留存指標時——當 AI 記住了一些非常私人的事情並用它來提供安慰時——我們知道這些架構上的頭痛是完全值得的。